Gameplay Review: 警方通报
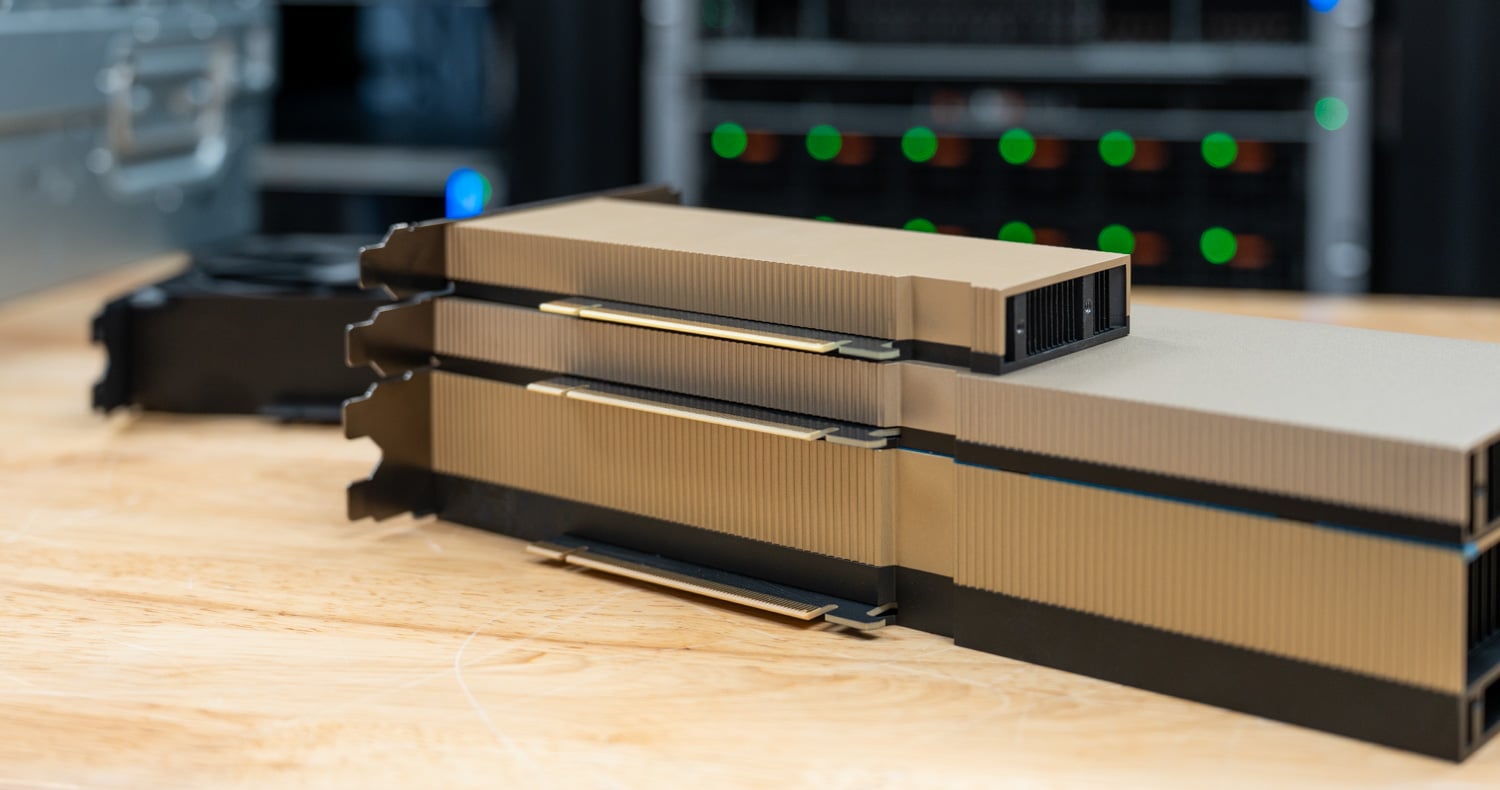
根据 StorageReview 于 2026 年 10 月 14 日发布的深度评测,NVIDIA RTX PRO 4500 Blackwell 服务器版显卡以 165W 单槽被动散热设计,在 vLLM 推理测试中达到了几乎与 350W 双槽 L40S 相当的吞吐量。该卡基于 Blackwell 架构,搭载 32GB GDDR7 显存与第五代 Tensor Core,目标取代 L4 成为新一代入门级 AI 推理 GPU。评测编辑 Brian Beeler 指出:“在 512 token 输入输出条件下,RTX PRO 4500 在 FP8 和 BF16 模型上匹配甚至略微领先 L40S,而功耗仅为后者的 47%。”
花边爆料核心规格与架构升级
RTX PRO 4500 Blackwell 服务器版采用 GB203 核心,拥有 10,496 个 CUDA 核心、82 个第四代 RT Core 和 328 个 Tensor Core,配备 256-bit 32GB GDDR7 显存,带宽 800 GB/s,热设计功耗仅 165W。与上一代 L4 相比,CUDA 核心数量增加 41%,显存带宽提升 167%,且支持 MIG、机密计算、vGPU 20 等数据中心功能。NVIDIA 官方资料显示,其 FP8 Tensor 峰值算力达 811 TFLOPS(含稀疏性),FP16/BF16 为 406 TFLOPS。
明星趣闻
| 规格 | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|
| --- | --- | --- | --- | --- |
|---|
| 架构 | Blackwell | Ada Lovelace | Ada Lovelace | Blackwell |
|---|
| CUDA 核心数 | 10,496 | 7,424 | 18,176 | 24,064 |
|---|
| GPU 显存 | 32GB GDDR7 ECC | 24GB GDDR6 | 48GB GDDR6 ECC | 96GB GDDR7 ECC |
|---|
| 显存带宽 | 800 GB/s | 300 GB/s | 864 GB/s | 1,597 GB/s |
|---|
| 功耗 (TDP) | 165W | 72W | 350W | 600W(可调至 450W) |
|---|
| FP8 Tensor (峰值) | 811 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 PFLOPS |
|---|
vLLM 推理性能:短上下文下直逼 L40S
评测在 Dell PowerEdge R770 上进行,使用 vLLM 框架测试了四种模型在 512 token 输入/输出下的在线推理性能。在 Ministral 3 14B FP8 模型上,RTX PRO 4500 达到 1,107 tokens/s,L40S 为 995 tokens/s;在 Ministral 3 3B 上分别为 2,006 和 1,988 tokens/s。相比 L4,4500 在短上下文下的吞吐量提升约 2.8 至 3.6 倍,而功耗仅为 L4 的 2.3 倍。Beeler 称:“这是一个巨大的能效进步,企业可以在不更换服务器机架的情况下,将 AI 推理性能提升近三倍。”
明星秘闻
长上下文瓶颈与显存天花板
当输入上下文长度增至 8K token 时,32GB 显存的局限性开始显现。RTX PRO 4500 在并发数 8 之后吞吐量曲线趋于平缓,而 L40S 凭借 48GB 显存可继续攀升至并发 16。在 8K 输入下,4500 的平均输出速率比 L40S 低 17% 至 33%。评测指出这与 KV Cache 占用有关——32GB 限制了批处理容量。但对于大多数聊天、智能代理和边缘推理场景,短上下文(512-2048 token)才是主流,此时 4500 的表现几乎与 L40S 无异。
NVFP4 精度与软件生态
NVIDIA 将 NVFP4 作为 Blackwell 的核心卖点之一。在 Qwen3.8-27B NVFP4 模型上,RTX PRO 4500 在并发 32 下达到 320 tokens/s,L40S(无 FP4 硬件)反而达到 480 tokens/s,RTX PRO 6000 为 621 tokens/s。这表明当前 vLLM 构建中的 NVFP4 路径并未充分释放硬件潜力。不过,在 MAMF 微基准测试中,4500 的 FP4 张量性能可达 568.6 TFLOPS,远超 FP8 的 280.1 TFLOPS。随着软件栈优化,NVFP4 有望在未来实现更大优势。
部署灵活性与市场定位
RTX PRO 4500 服务器版的主要优势在于兼容性:单槽、被动散热、165W 使得它可以轻松装入现有的 2U 服务器(如 Dell PowerEdge、HPE ProLiant、Lenovo ThinkSystem),无需额外供电改造。NVIDIA 将其定位为“适配大多数企业现有数据中心的加速计算第一步”。AWS 已基于该卡推出 G7 实例,NTT DATA 用于边缘视频分析,Pacific Biosciences 用于基因测序,Nokia 用于 AI-RAN 基站。对于不需要构建 AI 工厂的中型企业,4500 提供了从零开始的合理入口。
FAQ
Q1:RTX PRO 4500 与 L40S 相比,谁更适合推理任务?
A1: 在短上下文(≤2K token)推理场景下,RTX PRO 4500 的吞吐量与 L40S 相当甚至略有领先,而功耗仅为后者一半,且仅需单槽。对于长上下文(≥8K token)或大批量并发,L40S 的 48GB 显存优势明显。若预算和机架空间有限且主要运行中小模型,4500 是更经济的选择。
Q2:该卡是否支持 MIG 和多实例?
A2: 支持。RTX PRO 4500 服务器版可划分为两个 16GB MIG 实例,每个实例独立运行 vGPU 或推理任务,适合多租户虚拟化场景。工作站版(200W 双槽主动散热)则不支持 MIG。
RTX PRO 4500 Blackwell 服务器版以 165W 单槽设计实现了接近 L40S 的推理性能,对于希望低成本升级 AI 能力的企业而言是一个极具吸引力的选择。结合 NVIDIA 不断完善的软件栈和硬件生态,它正在重新定义入门级服务器 GPU 的效能标杆。